OCR: como transformar documentos em dados e ganhar eficiência?
Documentos fazem parte de praticamente todas as operações empresariais. Contratos, certidões, notas fiscais, comprovantes, matrículas, formulários e outros arquivos concentram informações importantes para diferentes processos. No entanto, quando esses dados permanecem presos em imagens ou PDFs, as equipes ainda precisam dedicar tempo para localizar, interpretar e registrar essas informações manualmente.
É nesse contexto que entra o OCR, sigla para Optical Character Recognition, ou reconhecimento óptico de caracteres.
A tecnologia permite identificar textos presentes em imagens e transformá-los em informações que podem ser lidas e processadas por sistemas. Dessa forma, um documento que antes funcionava apenas como um arquivo passa a fornecer dados que podem participar de outros processos.
Essa transformação ganhou ainda mais relevância com o avanço da inteligência artificial. Em junho de 2026, a IBM destacou que grande parte do conhecimento empresarial continua armazenada em documentos complexos, como PDFs, imagens e apresentações, e que transformar esse conteúdo em dados estruturados é importante para aplicações de IA em escala.
O que é OCR?
OCR é uma tecnologia capaz de reconhecer caracteres presentes em uma imagem e convertê-los em texto legível por máquina.
Imagine, por exemplo, que uma empresa receba uma certidão digitalizada em formato de imagem. Para uma pessoa, é possível abrir o arquivo e ler as informações normalmente. Entretanto, para um sistema, aquela imagem não necessariamente contém texto que possa ser pesquisado ou utilizado diretamente em um processo automatizado.
O OCR atua justamente nessa etapa, a tecnologia identifica os caracteres presentes na imagem e cria uma camada de texto que permite pesquisar, copiar e processar as informações. Ajudando a transformar um documento visual em uma fonte de dados.
Como funciona o reconhecimento óptico de caracteres?
Embora o processo possa parecer simples para quem utiliza a tecnologia, o reconhecimento envolve diferentes etapas.
Primeiramente, o sistema recebe a imagem ou o documento digitalizado, em seguida, identifica elementos visuais que podem representar caracteres. Depois, interpreta letras, números e símbolos para formar palavras e informações estruturadas.
A qualidade do documento influencia diretamente esse processo, imagens com baixa resolução, textos inclinados, manchas, diferentes fontes ou layouts muito complexos podem dificultar o reconhecimento. Por isso, sistemas modernos combinam OCR com outras técnicas de processamento de documentos e inteligência artificial.
A própria AWS destaca que documentos empresariais apresentam diferentes formatos, layouts e idiomas, o que torna a extração de informações um desafio quando as empresas dependem apenas de processos tradicionais. Dessa forma, o OCR representa uma etapa importante, mas nem sempre é suficiente sozinho.
OCR e inteligência artificial são a mesma coisa?
Não, essa é uma diferença importante para entender a evolução do processamento documental.
O OCR tem como principal função reconhecer e converter caracteres presentes em uma imagem. A inteligência artificial, por outro lado, pode interpretar essas informações, identificar padrões, classificar documentos e extrair dados de acordo com o contexto.
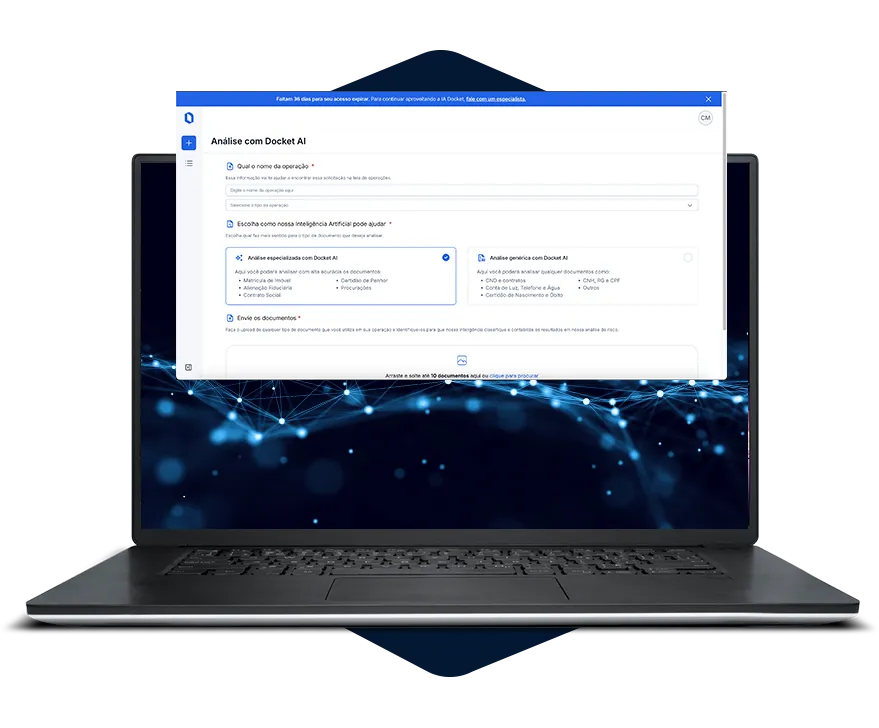
Imagine uma empresa que recebe milhares de documentos de diferentes tipos. O OCR pode transformar o conteúdo visual em texto. Depois, modelos de IA podem identificar se aquele arquivo corresponde a uma certidão, contrato, comprovante ou outro tipo de documento.
Além disso, a IA pode localizar informações específicas dentro do conteúdo. Assim, a tecnologia deixa de apenas responder “o que está escrito neste documento?” e passa a ajudar a responder “quais informações deste documento são relevantes para este processo?”
Essa evolução faz parte do chamado Intelligent Document Processing, ou processamento inteligente de documentos.
A AWS descreve esse modelo como uma combinação de tecnologias como OCR, visão computacional, processamento de linguagem natural e machine learning para classificar documentos, extrair informações e utilizá-las em processos empresariais.
Por que transformar documentos em dados?
A principal vantagem está na possibilidade de utilizar informações que antes estavam isoladas dentro dos arquivos. Quando um dado permanece apenas em um PDF, por exemplo, uma pessoa pode precisar abrir o documento e procurar manualmente pela informação. Quando esse dado passa a uma estrutura que um sistema consegue interpretar, ele pode alimentar diferentes etapas do processo.
Consequentemente, a empresa pode utilizar essas informações para:
- preencher sistemas;
- classificar documentos;
- validar informações;
- localizar dados específicos;
- alimentar fluxos automatizados;
- apoiar análises;
- identificar inconsistências;
- reduzir atividades repetitivas.
Além disso, dados estruturados facilitam a integração entre diferentes sistemas.
Por isso, o valor do OCR não está apenas em eliminar a digitação manual. Ele está na possibilidade de transformar documentos em informações que podem circular pela operação.
Qual é o impacto do OCR na produtividade?
Imagine uma equipe responsável por analisar centenas ou milhares de documentos todos os meses, sem automação, os profissionais precisam abrir arquivos, localizar informações, copiar dados, preencher sistemas e revisar o resultado.
Esse processo pode consumir uma quantidade significativa de tempo, especialmente quando os documentos apresentam diferentes formatos.
Ao extrair informações automaticamente, o sistema pode realizar parte das tarefas repetitivas enquanto a equipe se concentra nas situações que realmente exigem análise humana.
A McKinsey já apontava que soluções de processamento inteligente de documentos, incluindo OCR, estavam entre as tecnologias de automação mais utilizadas além da fase de testes pelas organizações pesquisadas. A consultoria também destaca que o processamento inteligente permite ir além da simples digitalização, ajudando computadores a compreender os dados presentes nos documentos.
Portanto, o ganho não está necessariamente em substituir pessoas, mas em reduzir o tempo que elas dedicam às tarefas operacionais.
OCR pode reduzir erros de digitação?
Pode, principalmente quando substitui etapas manuais de transcrição. Quando uma pessoa precisa copiar informações de um documento para outro sistema, existe a possibilidade de cometer erros de digitação, inverter números ou deixar algum campo sem preenchimento.
No entanto, isso não significa que o OCR seja sempre 100% preciso, a qualidade da imagem, o tipo de documento, a organização das informações e o próprio conteúdo podem influenciar o resultado. Em documentos mais complexos, por exemplo, tabelas, campos sobrepostos e diferentes padrões de layout podem exigir tecnologias adicionais.
Um estudo publicado pela Anvisa em 2025 sobre automação de documentos fiscais identificou justamente desafios relacionados à qualidade da imagem, ruído, inclinação e diversidade de layouts durante o uso de OCR.
Por isso, processos automatizados precisam incluir mecanismos de validação e tratamento de exceções.
O que é processamento inteligente de documentos?
O OCR resolve uma parte do problema que é transformar imagem em texto, o processamento inteligente de documentos vai além. Ele combina diferentes tecnologias para entender o conteúdo dos arquivos e transformá-lo em informações que possam ser utilizadas em processos.
Em um fluxo desse tipo, uma empresa pode receber um conjunto de documentos e automatizar etapas como:
1. Captura: o sistema recebe os documentos.
2. Classificação: a tecnologia identifica o tipo de cada arquivo.
3. Extração: informações relevantes são identificadas e estruturadas.
4. Validação: os dados podem passar por regras ou verificações.
5. Encaminhamento: as informações seguem para o processo ou sistema correspondente.
Dessa forma, o documento deixa de ser o ponto final da operação e passa a funcionar como uma entrada para outros processos.
Onde o OCR pode ser utilizado?
As possibilidades são amplas porque praticamente qualquer operação que dependa de informações documentais pode se beneficiar da extração automatizada.
No setor financeiro, por exemplo, documentos podem participar de processos de cadastro, análise e concessão de crédito, já no mercado imobiliário, informações de matrículas, certidões e contratos podem ser utilizadas em diferentes etapas das operações.
Em empresas, contratos e documentos cadastrais podem alimentar processos de compliance, onboarding e gestão. Além disso, órgãos públicos também vêm aplicando inteligência artificial para análise documental.
Em abril de 2026, a Junta Comercial do Estado do Ceará lançou um serviço de análise documental com IA voltado para documentos empresariais. Segundo o governo estadual, a iniciativa representa o primeiro serviço do Governo do Ceará destinado ao cidadão com aplicação de IA para essa finalidade.
Esse movimento mostra que a aplicação da tecnologia não está restrita a grandes empresas de tecnologia. Ela já começa a aparecer em processos concretos de diferentes setores.
OCR é suficiente para automatizar documentos?
Nem sempre, essa é uma das principais diferenças entre simplesmente digitalizar documentos e criar uma operação documental inteligente. O OCR consegue reconhecer caracteres, porém, uma operação empresarial normalmente precisa de mais informações. É necessário identificar o tipo do documento, compreender seu contexto, localizar campos específicos, validar informações e, muitas vezes, relacionar aquele arquivo a uma operação.
Por exemplo, reconhecer que determinado documento contém o número de um CPF é diferente de entender a quem aquele CPF pertence, qual é sua relação com a operação e se a informação está de acordo com os demais documentos.
Por isso, soluções mais avançadas combinam OCR com inteligência artificial, regras de negócio, processamento de linguagem natural e outras tecnologias.
A evolução recente do processamento documental segue justamente nessa direção. Em 2026, a IBM destacou o uso de ferramentas capazes de transformar documentos complexos em dados estruturados e preparados para aplicações de IA.
Como a IA amplia o potencial do OCR?
A inteligência artificial permite interpretar informações de maneira mais contextual, em vez de apenas identificar uma sequência de caracteres, modelos mais avançados conseguem analisar a estrutura do documento e relacionar diferentes informações.
Isso permite, por exemplo, reconhecer campos mesmo quando eles aparecem em posições diferentes ou quando documentos possuem layouts variados. Além disso, modelos de IA podem classificar documentos e identificar informações relevantes de acordo com o objetivo da operação.
Por isso, o processamento documental passa a funcionar de maneira mais próxima da forma como uma pessoa analisa um arquivo, considerando não apenas as palavras, mas também o contexto em que elas aparecem.
Ao mesmo tempo, essa evolução exige atenção à qualidade dos dados e à governança, o Governo Digital, por exemplo, destaca em suas diretrizes recentes a importância de padrões de qualidade, catalogação, semântica comum, integração de dados e mecanismos de governança para o uso de inteligência artificial.
O que as empresas precisam considerar antes de automatizar documentos?
Antes de implementar uma solução, é importante entender o processo atual, quais documentos chegam à empresa? Em quais formatos? Quais informações precisam ser extraídas? Quem realiza essa atividade hoje? Quanto tempo a equipe dedica a ela? Quais erros aparecem com maior frequência?
Essas perguntas ajudam a identificar onde a automação realmente pode gerar valor, além disso, é importante avaliar a qualidade dos documentos. Documentos muito diferentes entre si podem exigir tecnologias mais sofisticadas. Da mesma forma, processos críticos precisam de mecanismos para revisão e tratamento de exceções.
Documentos empresariais podem conter dados pessoais, informações financeiras, contratos e outros conteúdos sensíveis. Portanto, qualquer automação precisa considerar regras de acesso, armazenamento, rastreabilidade e proteção das informações.
De OCR a dados: qual é o próximo passo?
A digitalização transformou documentos físicos em arquivos digitais. O OCR deu um passo além ao permitir que computadores reconhecessem o texto presente nesses arquivos. Agora, a evolução está em transformar esse conteúdo em dados estruturados e utilizáveis.
Esse movimento é especialmente relevante em empresas que trabalham com grandes volumes documentais. Afinal, quanto maior o número de arquivos, maior também o potencial de ganho ao automatizar tarefas repetitivas.
Além disso, documentos estruturados podem alimentar sistemas, automações e aplicações de inteligência artificial.
Consequentemente, a empresa passa a utilizar melhor uma fonte de informação que já fazia parte da sua operação, mas que muitas vezes permanecia isolada dentro de arquivos.
E o que podemos levar disso?
O OCR representa uma das etapas fundamentais da transformação de documentos em dados. Ao reconhecer textos presentes em imagens, a tecnologia cria condições para que informações antes acessíveis apenas pela leitura humana possam ser pesquisadas, processadas e utilizadas por sistemas.
No entanto, o verdadeiro potencial aparece quando o OCR trabalha em conjunto com inteligência artificial e processamento inteligente de documentos. Nesse cenário, a empresa não apenas digitaliza arquivos. Ela extrai informações, estrutura dados e conecta documentos aos processos do negócio.
Por isso, o desafio atual não é simplesmente deixar de usar papel. É fazer com que os documentos deixem de ser apenas arquivos e passem a funcionar como fontes de informação para operações mais rápidas, organizadas e inteligentes.